CBQ
CBQ: Cross-Block Quantization for Large Language Models阅读笔记
motivation
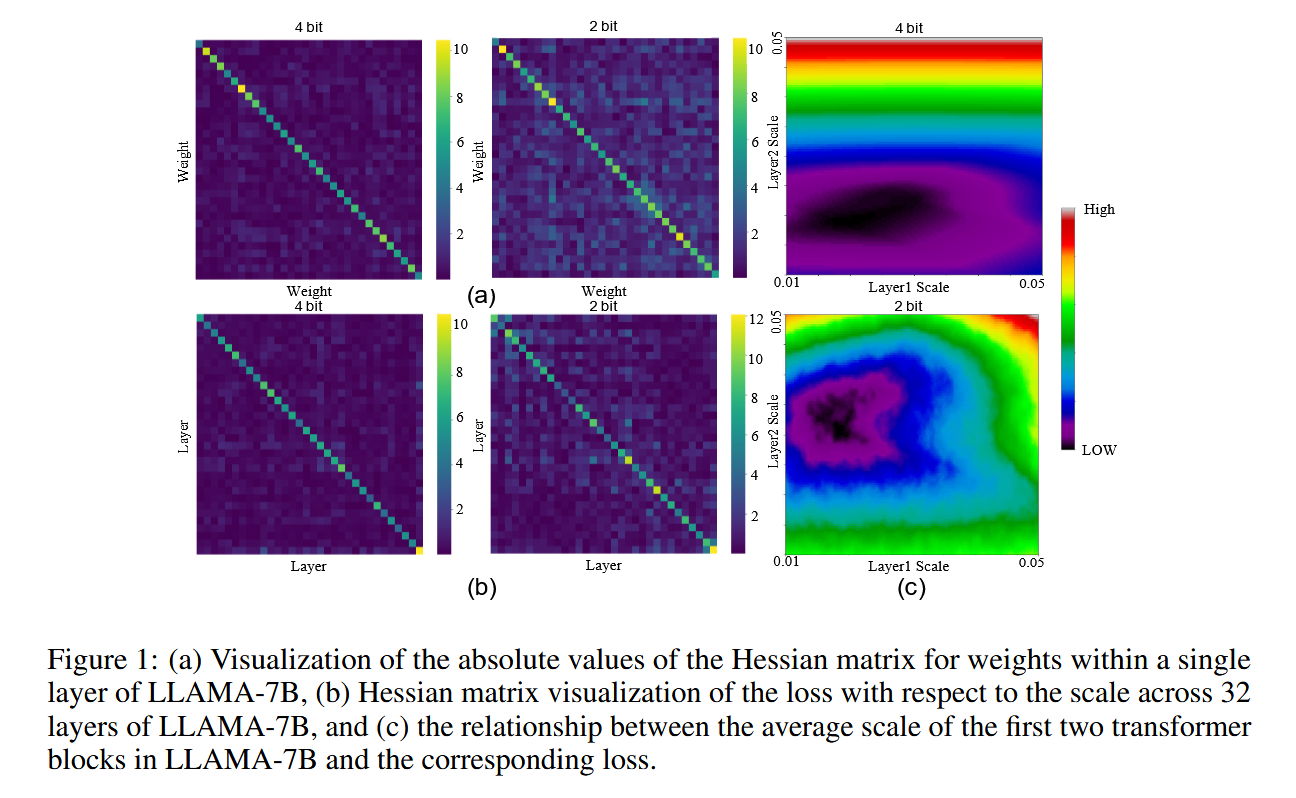
发现随着量化位宽数降低,层内关于权重的Hessian矩阵和层间Hessian矩阵非对角的值都逐渐增大。这代表随着量化位宽降低,层内不同参数的依赖性和层间依赖性均增高。
创新点1:由粗到细的异常值预处理
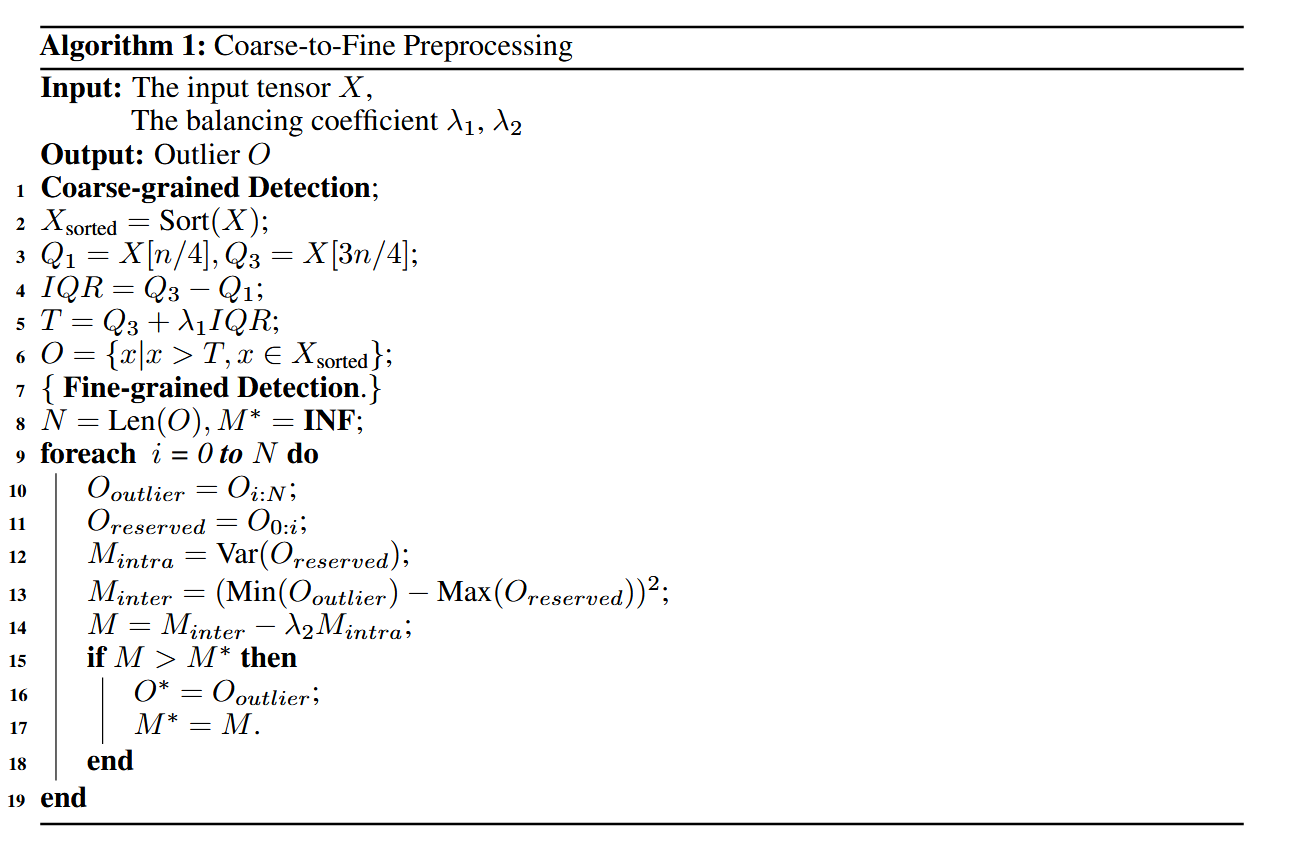
- 粗粒度检测:根据大小排序,通过上下四分位数快速选出异常值。
- 细粒度检测:最小化非异常值的方差,最大化异常值与非异常值的距离,遍历搜索出最优划分。
- 对于权重中的异常值直接截断,对于激活中的异常值进行逐通道缩放,缩放因子
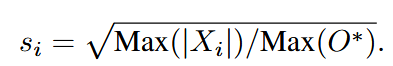 ,其中$O^*$是被截断的异常值的集合(应该是权重的异常值的集合?)。
创新点2:跨块重建
在连续多个block中一起优化内部所有的量化参数,使用了重叠滑窗的方式对整个模型进行连续优化。
优化目标:引入KL散度使得优化更加稳健。
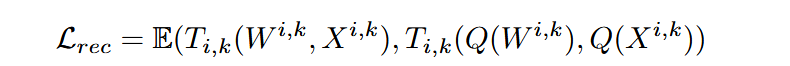
其中:
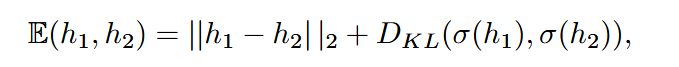
创新点3:LoRA-Rounding(LoRA版AdaRound)
- 大模型参数过多,直接训练舍入矩阵搜索空间过大,计算消耗过大且难以收敛。
- 将舍入矩阵进行低秩分解,$A_1$高斯初始化,$A_2$全零初始化。
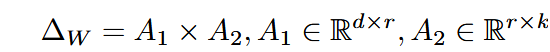
- 利用模拟退火策略分别训两个低秩矩阵,最后再舍入到0和1。
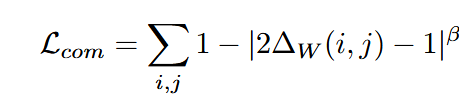
本博客所有文章除特别声明外,均采用 CC BY-NC-SA 4.0 许可协议。转载请注明来源 由本自性清净故,令诸爱染悉无垢!